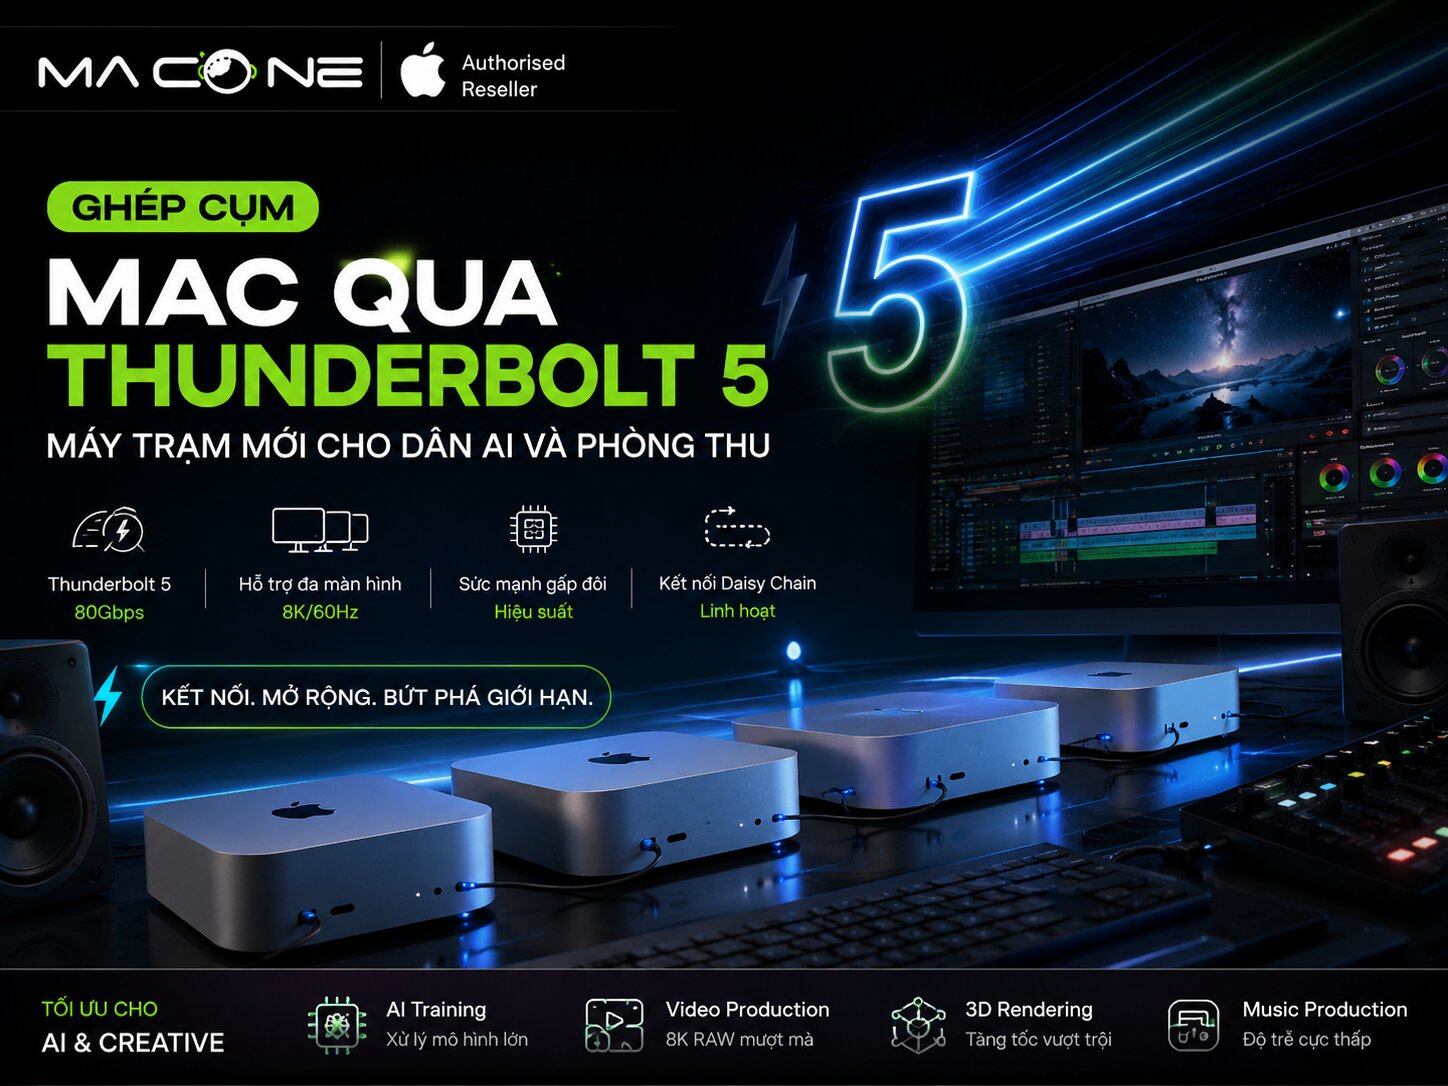
Ghép cụm Mac qua Thunderbolt 5: Máy trạm cho dân AI và phòng thu
Mình biết mấy anh em làm hậu kỳ video sẽ gật ngay: cái thùng máy trạm đặt góc phòng, bật lên là quạt ầm ầm, mùa hè phòng thu nóng thêm mấy độ, và hóa đơn điện tháng nào cũng làm mình nhíu mày. Đó là thực tế của dân làm video 8K, mix âm Dolby Atmos, hay voice-over chuyên nghiệp mấy chục năm nay.
Nhưng thẳng thắn mà nói, cái thùng to đó đang ngày càng mất lý do tồn tại — không phải vì phần cứng trong nó tệ hơn, mà vì bên ngoài đang xảy ra một cuộc dịch chuyển kiến trúc âm thầm nhưng triệt để. Thunderbolt 5 cho phép kéo mọi card chuyên dụng ra ngoài mà không mất băng thông. Bộ nhớ thống nhất (UMA — tức là CPU, GPU và Neural Engine dùng chung một bể RAM tốc độ cao) phá vỡ “bức tường VRAM” vốn là lý do dân AI local phải đau đầu với card đồ họa đắt đỏ. Và giao thức RDMA — truy cập trực tiếp bộ nhớ máy khác không cần làm phiền CPU của nó — vừa được Apple kích hoạt trong macOS Tahoe 26.2, cho phép nối nhiều Mac mini hoặc Mac Studio thành một cụm máy phân tán với tổng bộ nhớ hàng trăm GB.
Bài này đi thẳng vào ba câu hỏi thực tế: máy trạm cắm card PCIe đang gặp vấn đề gì; Thunderbolt 5 cùng cụm Mac giải quyết được bao nhiêu; và — quan trọng không kém — khi nào thì giải pháp này chưa đáng tiền.
Vì sao máy trạm nhiều khe cắm PCIe đang đụng trần
Cắm nhiều card vào — băng thông bắt đầu bị xẻ nhỏ
Máy trạm PCIe truyền thống hấp dẫn ở chỗ có nhiều khe mở rộng — tưởng “càng nhiều card càng mạnh”. Thực tế không hẳn vậy. Các bo mạch chủ thế hệ mới ngày càng phải chia làn đường PCIe cho nhiều thứ hơn: ổ SSD M.2 NVMe siêu tốc, cổng USB thế hệ mới, mạng Ethernet tốc độ cao — tất cả đều ăn chung “xa lộ” PCIe với khe cắm đồ họa. Kết quả: khi bạn cắm thêm card thứ hai hoặc thứ ba, khe cắm chính thường rớt từ PCIe 5.0 x16 xuống x8 hoặc x4 (theo Puget Systems và Tom’s Hardware).
Sự sụt giảm đó ra số liệu rõ ràng:
| Cấu hình PCIe | Băng thông mỗi chiều | Hiệu suất DaVinci Resolve | Hiệu suất Premiere Pro |
|---|---|---|---|
| PCIe 5.0 x16 | ~64 GB/s | 100% (chuẩn tham chiếu) | 100% (chuẩn tham chiếu) |
| PCIe 5.0 x8 / 4.0 x16 | ~32 GB/s | ~97% | ~97% |
| PCIe 5.0 x4 / 4.0 x8 | ~16 GB/s | ~90% | ~83% |
| PCIe 4.0 x4 / 3.0 x8 | ~8 GB/s | ~75% | ~65% |
Nguồn: Puget Systems, Tom’s Hardware, GIGAZINE (tổng hợp 2025–2026)
Với DaVinci Resolve, sụt giảm đến 25% khi băng thông bị bóp từ x16 xuống x4. Premiere Pro xử lý codec nặng như H.264 hoặc HEVC thì còn tệ hơn — 35% theo Tom’s Hardware. Mà 35% thời gian dựng phim không phải con số nhỏ khi bạn đang chạy deadline xuất video 8K cho khách.
Điện, nhiệt và tiếng ồn — ba thứ phòng thu không chịu nổi
Vấn đề băng thông chỉ là một trong ba. Cái khiến dân phòng thu thực sự đau đầu là điện và tiếng ồn.
Về điện: một hệ thống đa GPU chuyên dụng tiêu thụ 600W đến hơn 5.600W (theo localaimaster.com). Tính riêng Mac Studio M3 Ultra — máy mạnh nhất trong dòng Mac nhỏ gọn — chỉ ngốn 78W khi suy luận tải nặng và 14W khi chờ. Con số chênh lệch này không chỉ ảnh hưởng hóa đơn điện: nhiệt tỏa ra từ card đồ họa RTX 5090 chạy liên tục làm nóng cả phòng, thứ mà một phòng thu chuyên nghiệp không thể chấp nhận vì nó ảnh hưởng trực tiếp đến thiết bị âm thanh nhạy cảm.
Còn tiếng ồn — đây mới là điểm chết: PC dưới tải nặng có thể vượt 51 dB (theo localaimaster). Mac mini và Mac Studio duy trì 22–23 dB kể cả khi xử lý tác vụ nặng (theo Reddit r/macmini). Đặt cạnh nhau: 51 dB gần tương đương tiếng máy giặt đang vắt; 22 dB là mức nghe hầu như không thấy gì trong phòng yên tĩnh. Với studio lồng tiếng hay phòng hậu kỳ Dolby Atmos — hai môi trường đòi hỏi sự im lặng tuyệt đối — điều này là không thể thương lượng.
Nếu bạn đang thiết kế phòng thu và muốn tư vấn cụ thể cấu hình Mac Studio hay Mac mini phù hợp với hệ thống hiện có, macone.vn có dịch vụ tư vấn miễn phí — bao gồm cả giải pháp mở rộng qua Thunderbolt 5 mà mình sẽ nói ngay sau đây.
Thunderbolt 5 — một sợi cáp thay cho cả dàn khe cắm
80Gbps đối xứng, 120Gbps khi cần — con số đó nghĩa là gì trong thực tế
Thunderbolt 5 tăng băng thông tiêu chuẩn lên 80Gbps đối xứng — gấp đôi Thunderbolt 4 (theo Plugable và Velocity Micro). Điểm thú vị hơn là tính năng “bandwidth boost”: khi phát hiện luồng dữ liệu hướng ra màn hình, hệ thống tự chuyển sang chế độ bất đối xứng — truyền xuống 120Gbps và truyền lên 40Gbps.
Trong thực tế, một cổng Thunderbolt 5 duy nhất có thể điều khiển đồng thời ba màn hình 4K@144Hz hoặc hai màn hình 8K@60Hz (theo Plugable). Với kỹ sư màu sắc cần timeline + bảng tham chiếu màu + màn hình tham khảo hiển thị cùng lúc, đây là thứ trước đây bắt buộc phải có cả dàn card đồ họa nhiều đầu ra.
Một lưu ý thực tế đáng nhớ: cáp Thunderbolt 5 thụ động chỉ đảm bảo 80Gbps trong phạm vi dưới 1 mét. Cáp dài hơn bắt buộc dùng cáp chủ động để tránh mất tín hiệu — điều này ảnh hưởng trực tiếp đến việc bố trí thiết bị trong phòng thu.
Đưa card chuyên dụng ra khỏi thùng máy — không cần Mac Pro nữa
Thunderbolt 5 nâng thông lượng PCIe từ Gen 3 x4 lên Gen 4 x4 (~64Gbps), cho phép ổ SSD gắn ngoài đạt tốc độ thực tế khoảng 6.700 MB/s (theo Plugable). Với dân hậu kỳ, đây là đủ để biên tập trực tiếp file RAW 8K hoặc dự án âm thanh đa lớp ngay trên ổ lưu trữ bên ngoài — không cần sao chép vào ổ trong máy trước khi làm việc.
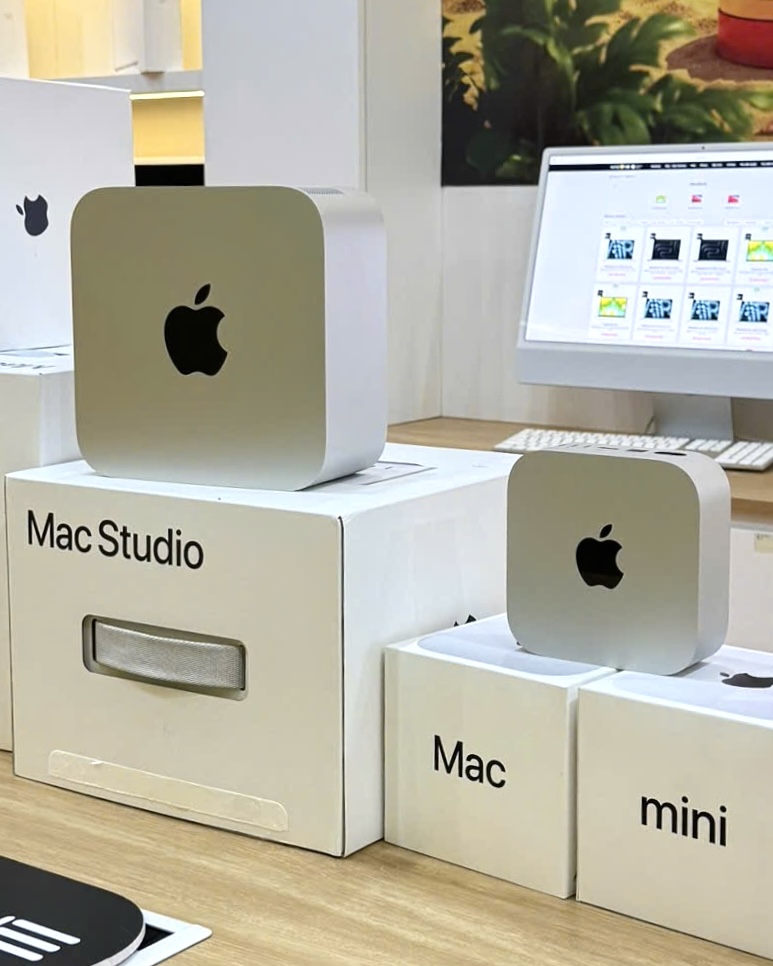
Nhưng ý nghĩa lớn hơn: những card chuyên dụng từng bắt buộc phải nằm trong thùng Mac Pro — card bắt tín hiệu Blackmagic DeckLink, card mạng 25GbE, card xử lý tín hiệu số Pro Tools HDX — giờ có thể nằm trong hộp mở rộng gắn ngoài qua Thunderbolt 5, kết nối vào Mac mini hay Mac Studio mà vẫn giữ được băng thông cần thiết. Hai thiết bị đáng chú ý:
- OWC StudioStack — hộp lưu trữ + mở rộng cho Mac Studio, tích hợp khe NVMe M.2 cho bộ nhớ đệm tốc độ cao cùng khay SATA cho lưu trữ thư viện âm thanh. Đạt 6.302 MB/s thực tế trên cổng Thunderbolt 5 (theo OWC), hệ thống tản nhiệt im lặng — hợp cho phòng thu âm.
- Sonnet xMac Studio / Echo II DV T5 — khung 3U cung cấp hai khe PCIe 4.0 x16 với Thunderbolt 5 riêng từng khe, mỗi khe đạt 6.000 MB/s (theo Sonnet). Cắm card Blackmagic, Avid hoặc bất kỳ card PCIe nào vào Mac nhỏ gọn.
Kỷ nguyên card DSP đắt đỏ đang khép lại
Đây là tin tốt cho dân sản xuất âm thanh: bạn có thể sẽ không cần mua thêm card DSP Pro Tools HDX nữa. Không phải vì nó hỏng — mà vì chip Apple Silicon giờ đủ mạnh chạy Logic Pro và Pro Tools Ultimate hoàn toàn bằng phần mềm, xử lý hàng trăm track có đầy đủ nén tiếng, bộ lọc tần số và các tính năng AI thế hệ mới như Stem Splitter (tách giọng hát và nhạc nền), Chromaglow (mô phỏng bão hòa âm analog) cùng Mastering Assistant — tất cả chạy trực tiếp trên Neural Engine của máy (theo Knuckle Duster và Apple Support).
Card DSP vật lý hiện chỉ còn đóng vai trò cổng giao tiếp kỹ thuật số DigiLink với phần cứng cũ — không còn là bộ não xử lý của hệ thống nữa (theo Sound on Sound và Reddit r/protools). Studio mới hoàn toàn có thể bỏ qua card DSP từ đầu; studio đang dùng hạ tầng DigiLink cũ thì vẫn cần giữ card để giao tiếp với phần cứng đó, nhưng không phải để chạy plug-in.
Ghép cụm Mac qua RDMA — và macOS Tahoe 26.2 làm được gì
RDMA là gì — giải thích không cần bằng cấp
Bình thường, khi hai máy trao đổi dữ liệu qua mạng TCP/IP thông thường, dữ liệu phải đi qua nhiều tầng giao thức hệ điều hành, và CPU của cả hai máy phải “bỏ tay ra đóng gói, giải nén, sao chép” — quá trình này tạo ra độ trễ tích lũy đáng kể theo từng tầng giao thức.
RDMA — Remote Direct Memory Access, tạm dịch là truy cập trực tiếp bộ nhớ từ xa — làm khác. CPU của máy này đọc và ghi thẳng vào vùng bộ nhớ của máy kia mà không làm phiền CPU bên nhận. Không có bước sao chép trung gian, không có tầng giao thức lót đường — dữ liệu đi thẳng. Độ trễ giảm từ mức hàng nghìn micro giây xuống dưới 10 micro giây (theo stabilise.io và Jeff Geerling).
Apple kích hoạt RDMA qua Thunderbolt 5 trong macOS Tahoe 26.2. Kết quả: bộ nhớ thống nhất của nhiều Mac trong cụm được gộp thành một khối logic duy nhất — GPU các nút có thể xử lý song song từng lớp của mô hình AI mà không phải xếp hàng chờ dữ liệu tuần tự.
Dây nối, sơ đồ và lưu ý phần cứng
Hiện chưa có thiết bị chuyển mạch nào hỗ trợ Thunderbolt 5 trên thị trường, nên cụm Mac bắt buộc nối trực tiếp theo sơ đồ vòng (Mac A → Mac B → Mac C → Mac D → Mac A) hoặc dạng lưới. Song song đó, tất cả các nút vẫn cần một bộ chuyển mạch Ethernet thông thường để quản trị qua SSH và giám sát hệ thống (theo Saeree ERP).
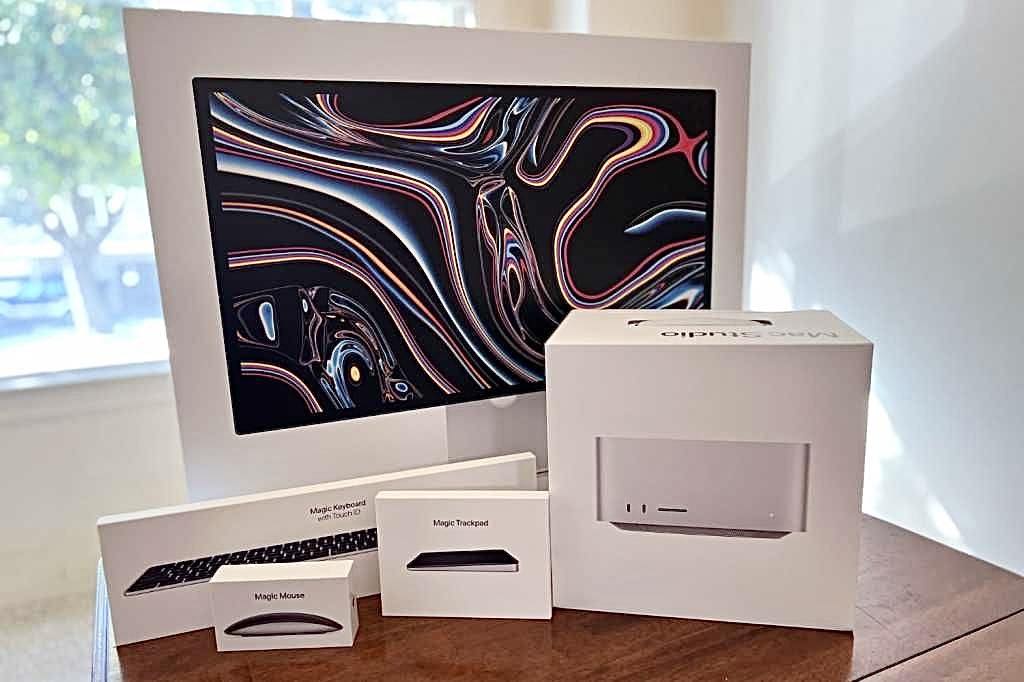
Lưu ý quan trọng khi mua Mac Studio: không dùng cổng Thunderbolt 5 liền kề cổng Ethernet để chạy luồng RDMA — hai cổng đó chia sẻ đường bus nội bộ và có thể làm giảm hiệu năng (theo Jeff Geerling). Quy trình thiết lập cụm gồm 7 bước chính: kích hoạt phần cứng RDMA từ Recovery Mode, cấu hình mạng Thunderbolt Bridge (dải 169.254.x.x, băng thông 40–80Gbps), ưu tiên dịch vụ mạng, đồng bộ tài khoản quản trị, thiết lập khóa SSH không mật khẩu, cài đặt môi trường Python 3.11 cùng thư viện MLX, và cuối cùng là cài trình điều phối Exo 1.0 (theo webAI).
Exo 1.0 so với llama.cpp — con số thực tế
Có hai trình điều phối phổ biến hiện nay để chạy mô hình AI trên cụm Mac. llama.cpp dùng RPC — giao thức gọi thủ tục từ xa — để phân chia mô hình qua các nút. Vì RPC phải đi qua tầng giao thức mạng thông thường, độ trễ tích lũy tăng dần theo số nút: cụm càng nhiều máy, tốc độ mỗi nút đóng góp thêm càng giảm.
Exo 1.0 tận dụng RDMA để song song hóa tensor trực tiếp trên bộ nhớ chung — băng thông tăng gần tuyến tính theo số nút. Kết quả trên cụm 4 Mac Studio: mô hình Qwen3 235 tỷ tham số đạt 32 tokens/giây; siêu mô hình Kimi K2 (dạng Mixture-of-Experts với 1 nghìn tỷ tham số) chạy ổn định khoảng 30 tokens/giây (theo AppleInsider và Jeff Geerling).
Vì sao dân AI local mê Mac mini và Mac Studio: phân tích thẳng thắn
Cụm Mac hoặc máy Mac đơn lẻ không phải lúc nào cũng “thắng” PC có card đồ họa mạnh. Nhưng với một nhóm tác vụ cụ thể — đặc biệt là chạy các mô hình ngôn ngữ lớn (LLM) cục bộ — chúng có lợi thế kiến trúc rõ rệt mà card đồ họa rời đơn thuần không thể vượt qua. Hãy đi vào từng lý do cụ thể.
Bộ nhớ thống nhất phá vỡ “bức tường VRAM” — đây là lý do cốt lõi
Trong kiến trúc PC truyền thống, CPU và GPU có vùng bộ nhớ hoàn toàn độc lập: RAM hệ thống (DDR5) và VRAM trên card đồ họa (GDDR6X). Khi chạy mô hình ngôn ngữ lớn, trọng số của mô hình phải đi qua một con đường dài và hẹp: từ ổ cứng vào RAM hệ thống, rồi qua khe PCIe — điểm nghẽn kinh điển — mới vào được VRAM để GPU xử lý. Nếu mô hình lớn hơn VRAM, hệ thống tràn bộ nhớ (OOM) hoặc buộc phải đẩy một phần dữ liệu ngược về RAM qua PCIe — tốc độ suy luận sụt xuống chục lần trong chớp mắt (theo XDA Developers).
Vấn đề là VRAM của card đồ họa dân dụng đang tiến chậm hơn nhiều so với quy mô mô hình AI. Card mạnh nhất hiện nay dành cho người dùng thông thường — RTX 5090 — cũng chỉ có 32GB VRAM (theo XDA). Trong khi đó, các mô hình mã nguồn mở thế hệ mới đang bùng nổ về quy mô. DeepSeek R1 phiên bản đầy đủ 671 tỷ tham số (lượng tử hóa mức Q4) cần tối thiểu khoảng 400GB bộ nhớ (theo Bizon-tech). Một card RTX 5090 — hay thậm chí hai card cộng lại — không thể nạp nổi mô hình này. Chưa kể giá một card RTX PRO 6000 doanh nghiệp cấp 96GB VRAM đã chạm 5.000–7.000 USD, và để đạt 384GB VRAM tổng thì cần đến 4 card như vậy.
Kiến trúc bộ nhớ thống nhất (UMA) của Apple giải quyết điều này theo cách triệt để hơn: CPU, GPU và Neural Engine dùng chung một bể bộ nhớ băng thông cao duy nhất — đặt ngay cạnh nhau trên cùng một chip, không có bước sao chép qua PCIe, không có “bức tường” phân cách. Toàn bộ RAM của Mac đều có thể dùng như VRAM. Một Mac Studio M3 Ultra cấu hình 256GB bộ nhớ thống nhất — cấu hình tối đa hiện tại — có thể nạp gọn DeepSeek R1 671B và suy luận ở tốc độ 15–20 tokens/giây (theo localaimaster). Đây là tác vụ mà trước đây chỉ có hệ thống máy chủ đa GPU chuyên dụng giá hàng chục nghìn USD mới thực hiện được.
Cần thêm bộ nhớ? Dùng cụm. Bốn Mac Studio M3 Ultra kết nối qua RDMA = gần 1TB bộ nhớ thống nhất dùng chung. Khi cân nhắc cấu hình Mac Studio RAM cao, macone.vn có đầy đủ dòng M3 Ultra từ 192GB đến 256GB — trả góp 0% và tư vấn cấu hình miễn phí, khá hợp lý với khoản đầu tư lớn như thế này.
Hiệu năng theo quy mô mô hình: bảng so sánh trung thực
Quan trọng nhất ở phần này: Mac không thắng tuyệt đối ở mọi quy mô. Dưới đây là bức tranh đầy đủ.
Mô hình nhỏ (7B–8B tham số)
Đây là sân chơi của card đồ họa NVIDIA. RTX 4090 với băng thông bộ nhớ GDDR6X ~1TB/s cùng các nhân Tensor chuyên dụng cho tốc độ vượt trội: Llama 3.2 8B đạt 142 tokens/giây trên PC, so với 76 tokens/giây trên Mac Studio M3 Ultra — PC thắng gần gấp đôi (theo localaimaster.com). Nếu bạn chỉ chạy mô hình cỡ này và tốc độ là ưu tiên hàng đầu, một PC có card đồ họa mạnh vẫn là lựa chọn hợp lý hơn về chi phí.
Mô hình trung bình (32B–34B tham số)
Điểm gãy bắt đầu xuất hiện. RTX 4090 có 24GB VRAM — khi gặp mô hình Qwen 2.5 Coder 32B lượng tử hóa Q5, nó tràn bộ nhớ ngay lập tức. PC buộc phải đẩy dữ liệu ngược qua PCIe về RAM hệ thống, tốc độ suy luận sụt giảm nghiêm trọng. Mac Studio M3 Ultra với 96GB bộ nhớ thống nhất xử lý cùng mô hình đó ở tốc độ 16 tokens/giây — ổn định, không giật, không xử lý tràn (theo localaimaster). Mức 16 tokens/giây là đủ nhanh cho hầu hết quy trình thực tế như trả lời câu hỏi, tóm tắt tài liệu hay hỗ trợ viết code.
Mô hình lớn (70B tham số trở lên)
PC đơn GPU bắt đầu mất khả năng vận hành trong thực tế. Llama 3.1 70B (Q4) trên PC phải đẩy khoảng 60% dữ liệu về RAM hệ thống — tốc độ rớt xuống 3,1 tokens/giây, gần như không dùng được trong thực tế (theo localaimaster). Mac Studio M3 Ultra xử lý toàn bộ trong bộ nhớ thống nhất, đạt 11,2 tokens/giây — chạy trơn tru, đủ để phục vụ nhiều người dùng đồng thời trong môi trường nội bộ.
| Mô hình (quy mô) | PC — RTX 4090 | Mac Studio M3 Ultra | Ghi chú |
|---|---|---|---|
| Llama 3.2 8B | 142 tokens/s | 76 tokens/s | PC vượt trội — GDDR6X nhanh hơn |
| Qwen 2.5 Coder 32B (Q5) | Tràn bộ nhớ | 16 tokens/s | RTX 4090 (24GB VRAM) không chứa nổi |
| Llama 3.1 70B (Q4) | 3,1 tokens/s | 11,2 tokens/s | PC đẩy 60% dữ liệu ra RAM — rất chậm |
| DeepSeek R1 671B (Q4) | Không chạy được | 15–20 tokens/s | Cần ~400GB — vượt mọi card rời đơn lẻ |
Nguồn: localaimaster.com, XDA Developers, Bizon-tech
Bức tranh trên lý giải tại sao dân phát triển ứng dụng AI, hệ thống tìm kiếm thông minh (RAG) và quy trình tác nhân tự động ngày càng chọn Mac. Không chỉ là tốc độ với mô hình lớn — mà còn là khả năng chạy đồng thời nhiều mô hình lớn trên cùng một bể bộ nhớ mà không cần sao chép dữ liệu giữa các mô hình. Một mô hình viết code song song với một mô hình hội thoại, cùng lúc, trên cùng một máy — điều đó trên PC đòi hỏi nhiều card đồ họa và rất nhiều công quản lý.
Nói thẳng giới hạn: ghép cụm Mac không phải lúc nào cũng đáng
Nhà phát triển Alex Ziskind đã thực nghiệm với cụm 5 Mac mini M4 và ghi lại kết quả thú vị. Một Mac mini M4 đơn lẻ đạt 70 tokens/giây với mô hình Llama 3.2 1B. Kết nối hai máy qua hub Thunderbolt trung gian: tốc độ rớt xuống 45 tokens/giây. Kết nối trực tiếp bằng cáp Thunderbolt chuyên dụng: vọt lên 95 tokens/giây. Mở rộng lên toàn cụm 5 nút: tụt về 67–74 tokens/giây (theo AppleInsider).
Nguyên nhân: mô hình 1B nhỏ quá — thời gian GPU tính toán trên từng ma trận trọng số ngắn hơn nhiều so với chi phí truyền dữ liệu qua mạng giữa các nút. Toàn cụm phải dừng chờ đồng bộ, và máy chậm nhất trong hệ thống quyết định tốc độ chung.
Bên cạnh đó, việc vận hành cụm Mac thực tế vẫn còn một số hạn chế: macOS không hỗ trợ nâng cấp phiên bản lớn qua SSH — phải truy cập thủ công từng máy bằng tay; benchmark tính toán nặng qua TCP thông thường (không qua RDMA) có thể làm driver mạng sụp và tự khởi động lại sau vài phút; các công cụ điều phối như Exo vẫn trong giai đoạn sơ khai (theo Jeff Geerling).
Tóm lại: ghép cụm Mac chỉ thực sự hợp lý với mô hình từ 70B tham số trở lên — nơi khối lượng tính toán trên từng nút lớn hơn nhiều so với chi phí truyền mạng giữa các nút. Với mô hình nhỏ, một Mac đơn lẻ — hay một PC có card đồ họa mạnh — sẽ cho tốc độ tốt hơn với ít phức tạp hơn nhiều.
Bài toán tiền: tổng chi phí sở hữu và chọn cấu hình theo nhu cầu
So sánh 5 năm: Mac Studio so với server đa GPU
Xây dựng hạ tầng VRAM tương đương bằng PC truyền thống tốn bao nhiêu? Một card đồ họa doanh nghiệp NVIDIA RTX PRO 6000 với 96GB VRAM có giá 5.000–7.000 USD mỗi chiếc. Để đạt tổng 384GB VRAM cần 4 card — riêng phần card đã hơn 28.000 USD, chưa tính vi xử lý Threadripper PRO, bo mạch chủ chuyên dụng, hệ thống làm mát và nguồn điện công suất lớn. Tổng có thể vượt 40.000 USD.
Bốn Mac Studio M3 Ultra kết nối cụm qua Thunderbolt 5 cung cấp tổng 768GB bộ nhớ thống nhất dùng chung với chi phí phần cứng khoảng 30.000 bảng Anh (theo stabilise.io).
So sánh TCO 5 năm giữa một Mac Studio M3 Ultra và một PC tự lắp trang bị RTX 4090:
| Hạng mục chi phí | Mac Studio M3 Ultra | PC tự lắp (RTX 4090) |
|---|---|---|
| Giá phần cứng ban đầu | ~3.199 USD (tân trang) | ~2.903 USD (linh kiện tự lắp) |
| Tiêu thụ điện khi chờ | 14W | 95W |
| Tiêu thụ điện khi suy luận 8B | 78W | 412W |
| Tiền điện ước tính (5 năm) | ~570 USD | ~1.690 USD |
| Nâng cấp phần cứng (năm thứ 3) | 0 USD | ~600 USD (nâng cấp GPU) |
| Tổng chi phí sở hữu (TCO) | ~4.068 USD | ~5.293 USD |
Nguồn: localaimaster.com
Chênh lệch TCO ~1.200 USD sau 5 năm trên một máy có thể trở thành con số lớn hơn nhiều khi nhân lên theo quy mô cụm, hoặc khi tính thêm chi phí điều hòa chuyên dụng mà dàn PC nhiều card đồ họa thường đòi hỏi.
Cấu hình nào phù hợp với nhu cầu nào
Không có “cấu hình tốt nhất cho tất cả” — chỉ có cấu hình phù hợp với từng nhu cầu cụ thể. Dưới đây là cách mình map từng use case:
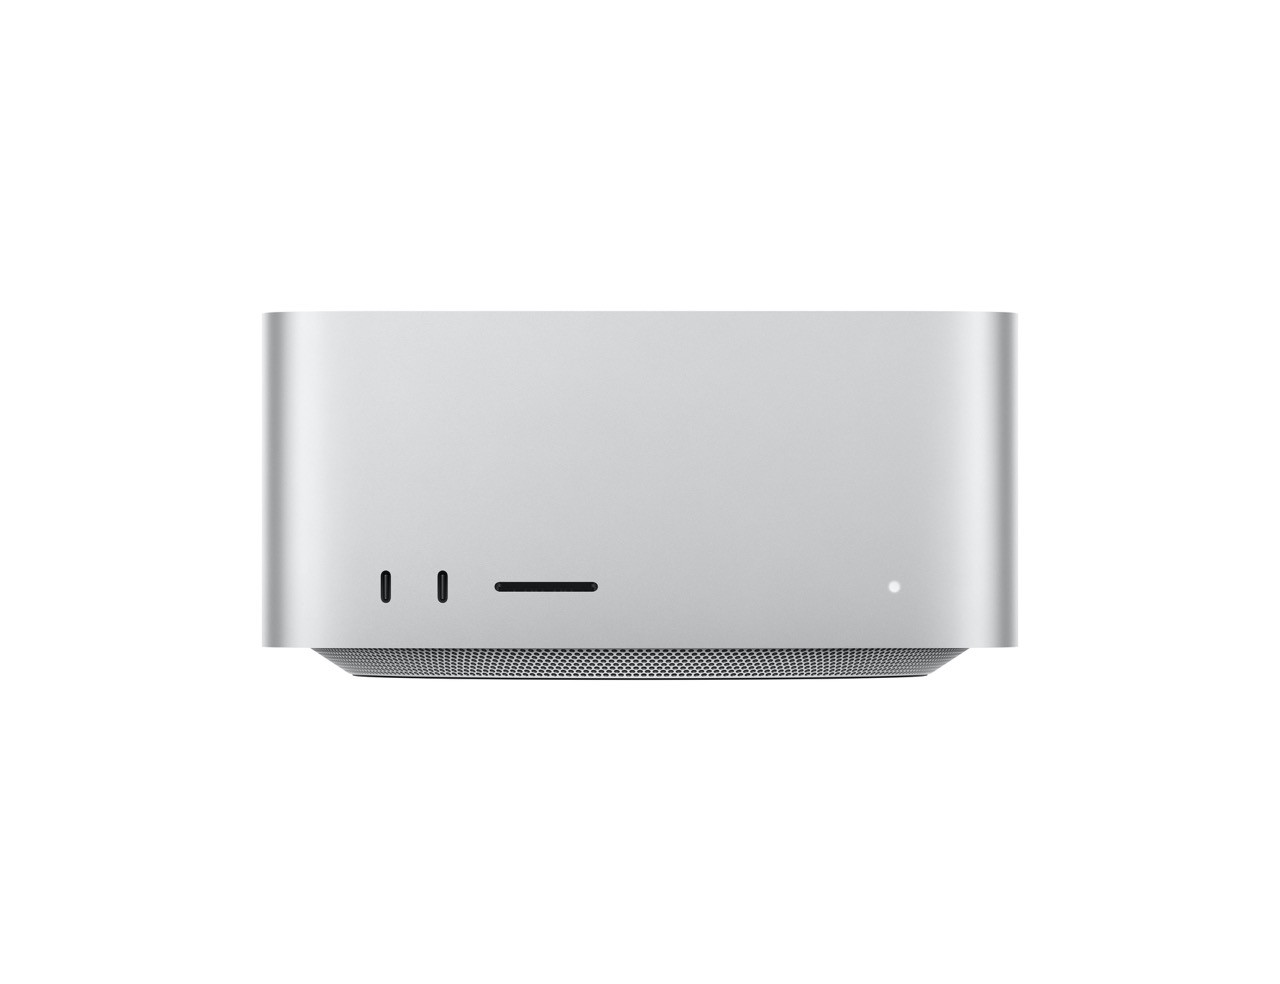
Phòng thu video 8K và hậu kỳ âm thanh Dolby Atmos: Mac Studio M4 Max hoặc M3 Ultra kết hợp hộp mở rộng Thunderbolt 5 (Sonnet xMac hoặc OWC StudioStack). Cấu hình này giải quyết ba vấn đề cùng lúc: im lặng hoàn toàn, băng thông để kết nối card bắt hình / card DSP qua hộp mở rộng, và đủ bộ nhớ thống nhất cho đa nhiệm nặng. Giá Mac Studio M4 Max (36GB, base) từ khoảng 54,99 triệu đồng tại macone.vn.
Phát triển AI local, mô hình trung và lớn (70B+): Mac Studio M3 Ultra 192GB hoặc 256GB là điểm khởi đầu thực dụng. Muốn chạy DeepSeek R1 671B hay Kimi K2 hoàn chỉnh — cụm 2–4 Mac Studio nối chuỗi Thunderbolt 5 với Exo 1.0. Giá Mac Studio M3 Ultra 96GB/1TB tại FPT Shop khoảng 119,99 triệu đồng (6/2026).
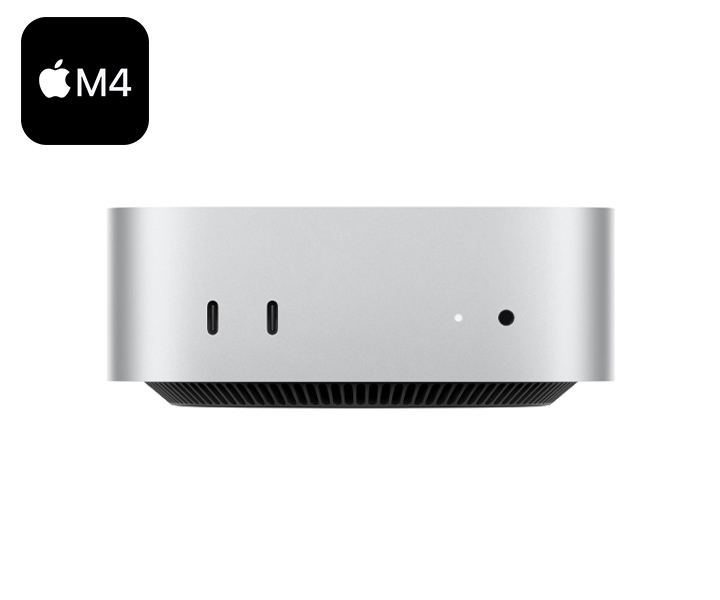
Doanh nghiệp nhỏ muốn hạ tầng AI nội bộ, ngân sách vừa phải: Bắt đầu bằng 2 Mac mini M4 Pro (48GB) nối trực tiếp một cáp Thunderbolt 5 — tổng 96GB bộ nhớ thống nhất, đủ chạy mô hình 32B–70B. Mac mini M4 Pro 48GB/512GB khoảng 44,09 triệu đồng tại TopZone (6/2026). Không muốn tự quản lý: thuê MiniCluster của MacWeb — gói 4 nút 256GB tổng từ 1.200 USD/tháng (theo MacWeb).
Mô hình nhỏ, ngân sách hạn chế, tốc độ là ưu tiên: Một Mac mini M4 24GB — từ 24,49 triệu đồng (TopZone 6/2026) — đủ dùng cho hầu hết mô hình 7B–13B. Thẳng thắn mà nói, nếu chủ yếu dùng mô hình <10B và muốn tốc độ tối đa, một PC có RTX 4090 vẫn là lựa chọn hợp lý hơn. Đừng mua Mac chỉ vì xu hướng khi nhu cầu thực tế không đòi hỏi.
Đừng dựng cụm ngay — lộ trình từng bước thực tế
Sai lầm phổ biến nhất mình thấy: người ta muốn dựng luôn cụm 4 nút ngay từ đầu. Vừa tốn tiền, vừa phức tạp không cần thiết ở giai đoạn thử nghiệm khi chưa biết mình thực sự cần gì.
Giai đoạn thử nghiệm: Bắt đầu với 2 Mac mini M4 Pro (64GB mỗi máy) + 1 cáp Thunderbolt 5 nối trực tiếp — không qua hub. Tổng bộ nhớ 128GB, đủ chạy thử mô hình 70B và test tương thích ứng dụng thực tế của bạn. Chi phí phần cứng khoảng 40–50 triệu VND tùy cấu hình (dựa trên giá TopZone 6/2026). Nếu dùng hub, như đã đề cập, tốc độ sẽ giảm đáng kể — cáp thẳng là bắt buộc.
Giai đoạn mở rộng: Khi đã xác nhận hiệu quả, nâng lên 4 Mac Studio M3 Ultra (192 hoặc 256GB) nối sơ đồ vòng — tổng bộ nhớ gần 1TB, đủ phục vụ 50–100 người dùng đồng thời trong môi trường doanh nghiệp (theo Saeree ERP). Trade-in Mac mini thử nghiệm tại macone.vn để giảm chi phí chuyển đổi — dịch vụ thu cũ ở đây nhận cả Mac mini và Mac Studio các đời.
Về bảo mật trong quá trình vận hành cụm: bật mã hóa FileVault trên tất cả các nút, triển khai MDM (Jamf Pro nếu quy mô doanh nghiệp), đặt mật khẩu quản trị phức tạp và giữ cụm máy trong tủ rack có khóa để hạn chế can thiệp vật lý (theo Saeree ERP).
Câu hỏi thường gặp
Thunderbolt 5 nhanh hơn Thunderbolt 4 bao nhiêu lần?
Thunderbolt 5 đạt 80Gbps đối xứng — gấp đôi Thunderbolt 4 (40Gbps). Trong chế độ “bandwidth boost” bất đối xứng phục vụ màn hình độ phân giải cao, băng thông truyền xuống có thể đạt 120Gbps. Riêng thông lượng PCIe cũng tăng từ Gen 3 x4 lên Gen 4 x4 (~64Gbps), cho phép ổ SSD gắn ngoài đạt ~6.700 MB/s thực tế — đủ để biên tập RAW 8K trực tiếp trên ổ ngoài (theo Plugable).
Cáp Thunderbolt 5 dài bao nhiêu thì vẫn giữ được băng thông?
Cáp thụ động (passive) chỉ đảm bảo 80Gbps khi dài dưới 1 mét. Với khoảng cách lớn hơn, bắt buộc phải dùng cáp chủ động (active) để tránh suy hao tín hiệu — chi phí cao hơn và cần tính trước khi bố trí thiết bị trong phòng. Đây là điểm thường bị bỏ qua khi thiết kế layout phòng thu (theo Velocity Micro).
Cắm được card Blackmagic DeckLink hay Avid HDX vào Mac mini không?
Được, qua hộp mở rộng PCIe kết nối Thunderbolt 5 như Sonnet xMac Studio hoặc Echo II DV T5. Mỗi khe PCIe 4.0 x16 trong các hộp này đạt 6.000 MB/s thực tế — đủ cho các card chuyên dụng đòi hỏi cao nhất. OWC cũng có giải pháp tương tự với hộp mở rộng Thunderbolt 5 (theo Sonnet, OWC).
Còn cần card DSP Pro Tools HDX nữa không?
Với studio mới hoàn toàn trên Apple Silicon: thực tế không cần nữa. Chip M-series đủ mạnh chạy Pro Tools và Logic Pro hoàn toàn bằng phần mềm, xử lý hàng trăm track có đầy đủ plug-in mà không cần phần cứng tăng tốc bên ngoài. Card HDX hiện chỉ cần thiết nếu bạn đang dùng phần cứng DigiLink cũ (I/O chuyên dụng, bảng điều khiển) và muốn tiếp tục giữ lại (theo Sound on Sound).
Ghép 2 Mac mini có nhanh gấp đôi khi chạy AI không?
Không nhất thiết và phụ thuộc rất nhiều vào quy mô mô hình. Với mô hình nhỏ dưới 10B tham số: chi phí truyền dữ liệu qua mạng lớn hơn lợi ích tính toán — cụm 2 máy có thể chậm hơn 1 máy nếu dùng qua hub. Ghép cụm chỉ có lợi rõ rệt từ 70B tham số trở lên, nơi mỗi nút phải tính toán một khối lượng lớn giữa hai lần truyền dữ liệu (theo AppleInsider, Alex Ziskind).
Mac Studio M3 Ultra với 256GB bộ nhớ thống nhất chạy được mô hình bao nhiêu tỷ tham số?
Với 256GB: đủ chứa DeepSeek R1 671B (Q4) một mình — mô hình này cần ~400GB, nên thực ra cần dùng cụm 2 máy để chứa gọn. Ở 192GB: chạy tốt các mô hình đến khoảng 120B (Q4). Tốc độ suy luận thực tế với R1 671B trên cụm M3 Ultra đạt 15–20 tokens/giây — đủ dùng cho môi trường nội bộ (theo localaimaster và Bizon-tech).
Mac có nhanh bằng RTX 4090 hay RTX 5090 khi chạy AI không?
Phụ thuộc hoàn toàn vào quy mô mô hình. Với 7B–8B: PC nhanh gần gấp đôi. Với 32B: PC tràn bộ nhớ, Mac chạy ổn. Với 70B trở lên: PC gần như không dùng được, Mac vẫn chạy trơn. Không có câu trả lời “tốt hơn” chung — chọn theo mô hình bạn thường xuyên dùng (theo localaimaster).
Một cụm 4 Mac Studio thực sự rẻ hơn server đa GPU chuyên dụng không?
So sánh bộ nhớ tương đương: 4 Mac Studio M3 Ultra (768GB tổng) khoảng 30.000 bảng Anh. Để đạt 384GB VRAM trên server đa GPU bằng RTX PRO 6000 (96GB × 4): hơn 28.000 USD chỉ riêng phần card, chưa tính phần còn lại. TCO 5 năm cho một máy đơn lẻ (Mac so với PC RTX 4090) chênh khoảng 1.200 USD nghiêng về phía Mac — chủ yếu nhờ tiết kiệm điện (theo localaimaster và stabilise.io).
Tự dựng cụm Mac có cần biết Terminal không?
Cần biết cơ bản: cách dùng SSH, một vài lệnh cài đặt, và chạy script Python. Không cần DevOps chuyên sâu hay quản lý hạ tầng. Khó nhất là giai đoạn đầu kích hoạt RDMA từ Recovery Mode và thiết lập SSH không mật khẩu. Sau khi cụm chạy ổn định, quản trị hàng ngày tương đối đơn giản (theo webAI).
Có thể thuê cụm Mac dạng dịch vụ thay vì tự mua không?
Có. MacWeb cung cấp MiniCluster — cụm Mac mini M4 Pro kết nối vật lý qua Thunderbolt 5, băng thông nội bộ 80Gbps. Gói 4 nút (256GB bộ nhớ thống nhất tổng, 56 nhân CPU, 80 nhân GPU): 1.200 USD/tháng. Gói 10 nút (640GB, 140 nhân CPU, 200 nhân GPU): 3.000 USD/tháng. Phù hợp để thử nghiệm trước khi quyết định mua phần cứng (theo MacWeb).
Mua Mac Studio hoặc Mac mini cấu hình RAM cao ở đâu tại Việt Nam, có trả góp không?
Mac Studio M4 Max (36GB) bắt đầu từ khoảng 54,99 triệu đồng và Mac mini M4 Pro (48GB) từ khoảng 44 triệu đồng — cả hai đều có ở macone.vn với dịch vụ trả góp 0% và nhận thu cũ. Giá thay đổi theo thời gian nên nên kiểm tra trực tiếp để có số chính xác nhất. macone.vn bán cả máy mới lẫn máy cũ chính hãng — nếu ngân sách eo, phương án Mac cũ cũng đáng cân nhắc.
Vậy ai thực sự nên dựng cụm Mac — và ai thì không?
Máy trạm cắm card PCIe không “chết” — nó đang lui về đúng vị trí của mình. Với mô hình AI nhỏ dưới 10B cần tốc độ tối đa, hay tác vụ đồ họa đòi hỏi băng thông GDDR6X cực lớn, một PC có card đồ họa mạnh vẫn là lựa chọn hợp lý và rẻ hơn. Đó là thực tế, và mình nghĩ quan trọng là phải nói thẳng ra.
Ngoài phạm vi đó — phòng thu im lặng cần chạy card chuyên dụng không ồn ào, AI local với mô hình 70B trở lên, hạ tầng suy luận nội bộ của doanh nghiệp nhỏ muốn tránh chi phí DevOps nặng — cụm Mac qua Thunderbolt 5 và RDMA trên macOS Tahoe 26.2 là hướng đi kiến trúc có nền tảng vững. Không phải vì Apple nói vậy, mà vì con số TCO, bộ nhớ thống nhất và kết quả benchmark thực tế chứng minh điều đó.
Cái giá phải trả: công cụ điều phối còn sơ khai, một số giới hạn vận hành cần xử lý thủ công, và bạn cần biết Terminal cơ bản. Jeff Geerling — người đã thực nghiệm kỹ nhất với cụm RDMA này — gọi nó là “đầy tiềm năng nhưng vẫn đang trưởng thành”. Đó là mô tả trung thực nhất.
Lời khuyên thực dụng: bắt đầu nhỏ với 2 Mac mini M4 Pro nối một cáp Thunderbolt 5. Thử với mô hình và ứng dụng thực tế của bạn. Khi biết mình cần gì thêm, mở rộng dần. Trade-in Mac mini khi lên đời Mac Studio — macone.vn nhận cả Mac mini và Mac Studio các đời, giúp giảm đáng kể chi phí leo thang theo từng giai đoạn.
Bài xem nhiều
Khắc phục lỗi mất chữ, nhảy chữ… khi gõ tiếng Việt trên macOS
Macbook Pro Retina cũ “thức dậy” chậm: Nguyên nhân và cách xử lý
3 cách giúp buộc tắt và khởi động lại thiết bị Mac của bạn
MacBook Air cũ có thể dùng màn hình cảm ứng với AirBar

Cách mở lại Apple ID bị khoá hoặc bị vô hiệu hoá
Hướng dẫn cài đặt các phần mềm Adobe 2020 trên MacBook.
Miễn phí giao hàng nội thành
Miễn phí đổi trong 10 ngày
Cam kết hàng chính hãng 100%
Tiền mặt, quẹt thẻ, chuyển khoản